UUBlog

UUBlog

本机使用 Tunnelblick / OpenVPN 访问 ChatGPT、Claude,同时保留国内 IP 直连。DNS 也需要分流,否则国内网站可能解析到海外节点,后面的连接跟着绕路。

以前按域名手动指定 DNS,这次改用 KixDNS 和 GeoSite 自动分流,再加上本地缓存。环境是 Apple Silicon Mac,记录下配置和维护过程。

国内网站为什么会绕到国外

应用先解析域名,再按目标 IP 路由。OpenVPN 按 IP 分流,DNS 返回的地址会影响后面走哪条路。

比如国内网站的查询跟着 VPN 发到海外 DNS。部分使用 CDN 的网站会根据解析器位置或查询携带的客户端子网信息选择节点,可能返回靠近海外解析器或代理出口的国外节点 IP。本机拿到这个 IP 后,又按海外路由走 VPN,访问国内网站也绕到了国外,速度就慢了。

国内域名使用国内 DNS,可以减少这种绕路。CDN 调度仍由网站决定,配置后需要检查实际目标路由。VPN 出口拥塞和带宽不足等原因,要另外排查。


flowchart TD
    A[访问国内网站] --> B[查询经 VPN 发往海外 DNS]
    B --> C[CDN 可能返回海外节点 IP]
    C --> D[目标 IP 命中海外路由]
    D --> E[网站连接也经过 VPN]
    E --> F[国内访问绕路变慢]

以前通过域名手动指定 DNS

以前 DNS 分流是在 macOS 的 /etc/resolver/ 里手动配的,按域名指定 nameserver。比如阿里云、腾讯云使用国内 DNS,需要海外解析的域名单独指定海外 DNS。

几个固定网站这样配就够用。但新增网站要逐个补规则,登录、接口和静态资源还可能使用不同域名,漏掉的查询仍走默认 DNS。

这次保留原来的上游选择,把规则迁入 KixDNS。GeoSite 负责覆盖更多域名,少量例外继续手动指定。

改用 KixDNS 后自动处理什么

系统统一查询本地 KixDNS。规则按自定义、GeoSite cn、默认海外的顺序匹配。旧的域名专用配置也已调整为查询本地服务,避免绕过它。

国内使用阿里 DoH,海外使用 Cloudflare 和 Google DoH。规则库已收录的域名自动分类,有遗漏或特殊需求时再加例外。

项目 以前手动配置 本地 KixDNS
域名分流 每个域名单独指定 DNS GeoSite 自动分类,自定义规则覆盖
规则维护 新网站逐个补配置 更新分类库,少量例外单独维护
重复查询 主要依赖系统和上游缓存 增加统一的本地缓存和后台刷新
检查问题 检查系统 resolver 和目标路由 日志直接显示管道、上游和缓存命中

缓存和后台刷新减少重复查询的等待,上游短暂失败时可在限定时间内返回旧缓存。解析速度的实测放在后面。

安全方面,应用到 KixDNS 的查询留在本机回环地址,KixDNS 到上游使用 DoH,开启 TLS 加密和证书校验,降低这段传输中查询被读取或响应被篡改的风险。转发时清除 ECS,不主动附带客户端子网信息。上游仍能看到收到的域名查询,所以要选择信任的解析服务。

服务只监听 127.0.0.1。浏览器自带 DNS、应用自行解析或 VPN 接管 DNS,都可能绕过它,需要单独检查。

整体访问流程

DNS 和访问流量分别处理。


flowchart TD
    A[应用发起 DNS 查询] --> B["本地 KixDNS<br/>127.0.0.1:53"]
    B --> C{缓存是否命中}
    C -->|命中| G[返回解析结果]
    C -->|未命中| D{域名分流}
    D -->|国内域名| E[阿里 DoH]
    D -->|海外及其他域名| F[Cloudflare / Google DoH]
    E --> G
    F --> G
    G --> H[应用向目标 IP 发起 HTTPS 连接]
    H --> I{macOS 系统 IP 路由}
    I -->|国内目标 IP| J[Wi-Fi 网关直连]
    I -->|海外目标 IP| K[OpenVPN 隧道]
    J --> L[国内网站]
    K --> M[海外网站]

这里沿用已有 OpenVPN 路由,下面只部署 DNS。网站是否走 VPN,最后通过目标路由和实际 HTTPS 连接验证。

编译 KixDNS

源码在 olicesx/kixdns。本次使用 Rust 1.98.1,编译的源码 commit 为 42981abe52ce53271be50b430594e02601e8b615。

1
2
3
4
5
6
7
8
mkdir -p "$HOME/localdns"
cd "$HOME/localdns"
git clone --depth 1 https://github.com/olicesx/kixdns.git
cd kixdns
# 固定到本次验证过的版本
git fetch --depth 1 origin 42981abe52ce53271be50b430594e02601e8b615
git checkout --detach 42981abe52ce53271be50b430594e02601e8b615
cargo +1.98.1 build --release --locked

需要先安装 Rust 1.98.1。本机 rsproxy 连接异常,实际从 /tmp 使用独立 CARGO_HOME 和官方 crates.io 构建,没有修改全局配置。

1
2
3
4
5
mkdir -p "$HOME/localdns/cargo-home"
cd /tmp
CARGO_HOME="$HOME/localdns/cargo-home" cargo +1.98.1 build \
--release --locked \
--manifest-path "$HOME/localdns/kixdns/Cargo.toml"

这里切到 /tmp 也有作用。从用户目录下构建时,Cargo 会沿父目录读取 .cargo/config.toml,仅换 CARGO_HOME 仍可能读到原来的镜像配置。

准备国内域名规则

GeoSite 使用 Loyalsoldier/v2ray-rules-dat 的数据。下载后检查 SHA-256,再安装到系统目录。

1
2
3
4
5
6
7
8
9
10
11
12
set -eu
mkdir -p "$HOME/localdns/data"
cd "$HOME/localdns/data"
RULES_URL=https://github.com/Loyalsoldier/v2ray-rules-dat/releases/latest/download
curl -fL "$RULES_URL/geosite.dat" -o geosite.dat
curl -fL "$RULES_URL/geosite.dat.sha256sum" -o geosite.dat.sha256sum
shasum -a 256 -c geosite.dat.sha256sum

sudo mkdir -p /usr/local/libexec /usr/local/etc/kixdns /usr/local/var/log/kixdns
sudo install -o root -g wheel -m 755 \
"$HOME/localdns/kixdns/target/release/kixdns" /usr/local/libexec/kixdns
sudo install -o root -g wheel -m 644 geosite.dat /usr/local/etc/kixdns/geosite.dat

后续更新方法放在维护部分。

配置分流和缓存


flowchart TD
    A[收到域名查询] --> B{命中自定义规则}
    B -->|是| C[采用指定管道]
    B -->|否| D{命中 GeoSite cn}
    D -->|是| E[国内管道 cn]
    D -->|否| F[海外管道 global]

配置保存在 /usr/local/etc/kixdns/pipeline.json。

下面是按本次部署整理的完整配置示例。其中 aliyun.com、cloud.tencent.com 固定走国内,manus.im 固定走海外。自定义规则之后匹配 GeoSite 的 cn,其余域名默认走海外。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
{
"version": "1.0",
"settings": {
"bind_udp": "127.0.0.1:53",
"bind_tcp": "127.0.0.1:53",
"min_ttl": 0,
"default_upstream": "https://1.1.1.1/dns-query",
"upstream_timeout_ms": 9000,
"request_timeout_ms": 22500,
"cache_capacity": 10000,
"cache_max_ttl": 3600,
"cache_background_refresh": true,
"cache_refresh_threshold_percent": 15,
"cache_refresh_min_ttl": 5,
"serve_stale": true,
"serve_stale_ttl": 30,
"serve_stale_expire_ttl": 300,
"serve_stale_ttl_reset": false,
"serve_stale_client_timeout_ms": 300,
"doh_pool_size": 8,
"geosite_data_paths": [
"/usr/local/etc/kixdns/geosite.dat"
]
},
"pipeline_select": [
{
"pipeline": "cn",
"matchers": [
{
"type": "domain_suffix",
"value": "aliyun.com"
}
]
},
{
"pipeline": "cn",
"matchers": [
{
"type": "domain_suffix",
"value": "cloud.tencent.com"
}
]
},
{
"pipeline": "global",
"matchers": [
{
"type": "domain_suffix",
"value": "manus.im"
}
]
},
{
"pipeline": "cn",
"matchers": [
{
"type": "geo_site",
"value": "cn"
}
]
},
{
"pipeline": "global",
"matchers": [
{
"type": "any"
}
]
}
],
"pipelines": [
{
"id": "global",
"rules": [
{
"name": "global-doh",
"matchers": [
{
"type": "any"
}
],
"actions": [
{
"type": "forward",
"upstream": [
"https://1.1.1.1/dns-query",
"https://8.8.8.8/dns-query"
],
"transport": "doh",
"ecs": {
"mode": "clear"
}
}
]
}
],
"ecs": {
"mode": "clear"
}
},
{
"id": "cn",
"rules": [
{
"name": "cn-doh",
"matchers": [
{
"type": "any"
}
],
"actions": [
{
"type": "forward",
"upstream": [
"https://223.5.5.5/dns-query",
"https://223.6.6.6/dns-query"
],
"transport": "doh",
"ecs": {
"mode": "clear"
}
}
]
}
],
"ecs": {
"mode": "clear"
}
}
]
}

同一组上游会并发查询,采用首个有效响应。上游地址都使用 IP,避免切换本地 DNS 后,还要先靠它解析自己的 DoH 上游域名。

原始测速使用 3 秒上游超时。复核时 VPN 下冷查询约需 4 秒,3 秒会误报 SERVFAIL,所以文中示例放宽到 9 秒,整体请求上限为 22.5 秒。加长超时只避免过早失败,不会让正常查询变快,仍需检查 VPN 和上游连通性。

缓存容量是 10000 条,尊重上游原始 TTL,最长保留 1 小时。TTL 剩余 15% 时触发后台刷新。上游暂时失败时允许返回旧缓存,最多过期 5 分钟,返回的 TTL 为 30 秒,并且关闭过期窗口重置,避免旧记录一直续下去。服务重启后内存缓存清空。

国内上游选阿里的两个已验证地址。DNSPod 的 IP HTTPS 地址在当时网络下连接超时,未加入配置。

这里还踩了一个配置字段的问题。文档里出现过 geosite,这次编译出的程序要求写成 geo_site,否则启动时会报 unknown variant。配置文件要用实际运行的版本验证一下。

用 launchd 管理服务

创建 /Library/LaunchDaemons/org.localdns.kixdns.plist。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0">
<dict>
<key>Label</key><string>org.localdns.kixdns</string>
<key>ProgramArguments</key>
<array>
<string>/usr/local/libexec/kixdns</string>
<string>run</string>
<string>-c</string><string>/usr/local/etc/kixdns/pipeline.json</string>
<string>--udp-workers</string><string>2</string>
</array>
<key>RunAtLoad</key><true/>
<key>KeepAlive</key><true/>
<key>ThrottleInterval</key><integer>10</integer>
<key>WorkingDirectory</key><string>/usr/local/etc/kixdns</string>
<key>EnvironmentVariables</key>
<dict><key>RUST_LOG</key><string>warn,kixdns::engine::phases=info</string></dict>
<key>StandardOutPath</key><string>/usr/local/var/log/kixdns/service.log</string>
<key>StandardErrorPath</key><string>/usr/local/var/log/kixdns/error.log</string>
<key>SoftResourceLimits</key>
<dict><key>NumberOfFiles</key><integer>4096</integer></dict>
<key>HardResourceLimits</key>
<dict><key>NumberOfFiles</key><integer>65536</integer></dict>
</dict>
</plist>

修正权限,检查语法,再启动。已安装过的服务先执行 sudo launchctl bootout system/org.localdns.kixdns,再执行 bootstrap。

1
2
3
4
5
6
7
8
sudo chown root:wheel /Library/LaunchDaemons/org.localdns.kixdns.plist
sudo chmod 644 /Library/LaunchDaemons/org.localdns.kixdns.plist
plutil -lint /Library/LaunchDaemons/org.localdns.kixdns.plist
sudo launchctl bootstrap system /Library/LaunchDaemons/org.localdns.kixdns.plist
sudo launchctl print system/org.localdns.kixdns

dig @127.0.0.1 www.baidu.com
dig @127.0.0.1 www.google.com +tcp

正式部署前先用 1053 端口验证,UDP、TCP、IPv6 记录和并发查询均正常。模拟上游故障时,旧缓存兜底和过期限制也通过了测试。

服务重启和日志维护命令放在后面。

切换 macOS 系统 DNS

先确认服务能解析,再保存原来的设置。

1
2
3
networksetup -listnetworkserviceorder
networksetup -getdnsservers "Wi-Fi"
scutil --dns

本机使用 Wi-Fi,原来没有手动指定 DNS,使用的是网络下发的地址。切换后只指定本地 DNS。

1
sudo networksetup -setdnsservers "Wi-Fi" 127.0.0.1

切换后刷新系统 DNS 缓存,再检查默认 nameserver。

1
2
3
sudo dscacheutil -flushcache
sudo killall -HUP mDNSResponder
scutil --dns

默认 resolver 应指向 127.0.0.1,.local 继续使用 mDNS。

验证 DNS 分流

直接查询可以确认 KixDNS 有回应,再用系统解析确认 macOS 真正在使用它。

1
2
3
4
5
6
7
8
9
10
11
12
dig @127.0.0.1 api.anthropic.com
dig @127.0.0.1 api.openai.com
python3 - <<'PYCODE'
import socket
for domain in ["www.baidu.com", "aliyun.com", "cloud.tencent.com",
"claude.ai", "api.anthropic.com", "chatgpt.com", "api.openai.com"]:
addresses = {item[4][0] for item in socket.getaddrinfo(
domain, 443, socket.AF_INET, socket.SOCK_STREAM)}
print(domain, sorted(addresses))
PYCODE

tail -n 30 /usr/local/var/log/kixdns/service.log

日志里检查 pipeline、upstream 和 cache_hit。本次验证,百度、阿里云和腾讯云使用 cn 管道,Claude、Anthropic API、ChatGPT 和 OpenAI API 使用 global 管道。

系统自身有缓存,重复解析可能不产生新的 KixDNS 日志。

验证访问流量

解析出来的 IP 还要检查路由。选择查询结果中的实际目标地址,执行下面的命令。

1
2
3
4
5
6
7
route -n get 160.79.104.10
# 检查 gateway 和 interface,本机 Claude 目标走 utun4

curl --noproxy '*' -4 -I -sS --connect-timeout 8 --max-time 15 \
-o /dev/null \
-w 'remote=%{remote_ip} local=%{local_ip} http=%{http_code}\n' \
https://claude.ai/

对其它网站同样检查。下面是当时全部解析地址的路由检查和实际 HTTPS 连接结果。

测试网站 DNS 管道 目标 IP 路由 HTTPS 连接源地址
百度 cn Wi-Fi en0 Wi-Fi 地址
阿里云及官网 cn Wi-Fi en0 Wi-Fi 地址
腾讯云及控制台 cn Wi-Fi en0 Wi-Fi 地址
Claude、Anthropic API global VPN utun4 VPN 地址
ChatGPT、OpenAI API global VPN utun4 VPN 地址

本机系统 HTTP/SOCKS 代理没有开启,海外连接由 Tunnelblick / OpenVPN 的系统路由接管。同一隧道访问 Cloudflare trace,出口检测为 SG。

部分 HEAD 请求返回 403、404 等状态,TCP/TLS 已建立。这只验证连接路径,不代表登录或认证 API 可用。VPN 重连或 CDN 地址变化后需要重新检查。

解析速度和缓存效果

测试时间是 2026 年 10 月 13 日,选了 12 个国内外域名。每轮启动一个临时 KixDNS 实例,做 3 轮冷缓存查询。随后在正式服务上预热,再对每个域名做 10 次缓存查询,不清空正在使用的服务缓存。

查询 A 记录,使用 UDP,超时 4 秒,不重试。计时直接从 socket 发出查询到收到响应,不包含进程启动,也不经过系统 DNS 缓存。

下面是耗时中位数,单位毫秒。

查询方式 国内域名 海外域名 整体
本地 DNS,未命中缓存 27.70 168.80 109.53
本地 DNS,命中缓存 0.143 0.142 0.142
直接查询 1.1.1.1 165.39 136.19 151.60
直接查询 8.8.8.8 173.85 165.97 166.36

120 次重复查询全部命中缓存,整体 P95 为 0.256ms。这次国内首次解析比两个海外公共 DNS 快约 6 倍。海外首次解析和直接查询 Google 接近,没测出明显加速,缓存命中后的收益更大。

本地上游走 DoH,对比公共 DNS 走 UDP,公共 DNS 自身的缓存无法清空。这是当前网络下的小样本结果,首次查询仍出现过约 1.2 秒的延迟尖峰,不能拿它当所有网络环境下的性能保证。

后续维护

更新 GeoSite 域名规则

GeoSite 规则可以每周检查一次。遇到分流异常时,先更新分类库,再判断是否需要加自定义规则。


flowchart TD
    A[下载到临时目录] --> B{下载及 SHA-256 校验成功}
    B -->|否| C[结束并保留原规则]
    B -->|是| D[备份现有规则]
    D --> E[安装新文件并替换]
    E --> F[重启服务并清空缓存]
    F --> G{解析与路由是否正常}
    G -->|是| H[完成更新]
    G -->|否| I[恢复备份并重启]

下面的脚本保存为 $HOME/localdns/update-geosite.sh。它先在临时目录下载并校验,成功后备份现有规则,再替换生效文件。下载或校验失败时,原规则不变。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
#!/bin/sh
set -eu

if [ "$(id -u)" != 0 ]; then
echo "请通过 sudo 执行"
exit 1
fi

RULE_DIR=/usr/local/etc/kixdns
RULE_URL=https://github.com/Loyalsoldier/v2ray-rules-dat/releases/latest/download
WORK_DIR=$(mktemp -d)
trap 'rm -rf "$WORK_DIR"' EXIT HUP INT TERM

curl -fLsS --connect-timeout 10 --max-time 180 \
"$RULE_URL/geosite.dat" -o "$WORK_DIR/geosite.dat"
curl -fLsS --connect-timeout 10 --max-time 30 \
"$RULE_URL/geosite.dat.sha256sum" -o "$WORK_DIR/geosite.dat.sha256sum"
(cd "$WORK_DIR" && shasum -a 256 -c geosite.dat.sha256sum)

cp -p "$RULE_DIR/geosite.dat" "$RULE_DIR/geosite.dat.previous"
install -o root -g wheel -m 644 \
"$WORK_DIR/geosite.dat" "$RULE_DIR/geosite.dat.new"
mv -f "$RULE_DIR/geosite.dat.new" "$RULE_DIR/geosite.dat"
launchctl kickstart -k system/org.localdns.kixdns

echo "规则已更新,服务已重启"

执行更新,然后检查服务和解析。

1
2
3
4
5
6
chmod +x "$HOME/localdns/update-geosite.sh"
sudo "$HOME/localdns/update-geosite.sh"
sudo launchctl print system/org.localdns.kixdns
dig @127.0.0.1 www.baidu.com
dig @127.0.0.1 api.openai.com
tail -n 20 /usr/local/var/log/kixdns/service.log

GeoSite 支持热加载。脚本主动重启,清掉旧缓存后重新解析。它只更新 DNS 分类,OpenVPN 的 IP 路由仍需独立维护。

如果更新后有异常,先恢复上一份规则。

1
2
3
sudo cp -p /usr/local/etc/kixdns/geosite.dat.previous \
/usr/local/etc/kixdns/geosite.dat
sudo launchctl kickstart -k system/org.localdns.kixdns

添加自定义域名规则

日志确认分类不合适后,在 pipeline_select 里添加例外,放到 geo_site 和最后的 any 之前。第一个命中的规则生效。

比如要让某个域名及其子域名走国内上游,可以加入下面这个条目,example.com 替换成自己的域名。指定海外上游时把 pipeline 改成 global。

1
2
3
4
5
6
7
8
9
{
"pipeline": "cn",
"matchers": [
{
"type": "domain_suffix",
"value": "example.com"
}
]
}

修改生效配置之前先备份,并检查 JSON 语法。

1
2
3
4
sudo cp -p /usr/local/etc/kixdns/pipeline.json \
/usr/local/etc/kixdns/pipeline.json.previous
sudo vi /usr/local/etc/kixdns/pipeline.json
python3 -m json.tool /usr/local/etc/kixdns/pipeline.json >/dev/null

管道规则支持热加载,无效配置会保留上一份有效配置。JSON 语法检查只能确认文件格式,最终还要检查服务日志和目标域名的实际解析。监听端口、缓存容量等初始化参数修改后需要重启服务。

检查日志和恢复系统 DNS

常用检查命令如下。

1
2
3
4
5
networksetup -getdnsservers "Wi-Fi"
scutil --dns
sudo launchctl print system/org.localdns.kixdns
tail -n 30 /usr/local/var/log/kixdns/service.log
cat /usr/local/var/log/kixdns/error.log

VPN 重连后检查 DNS 是否仍指向本地,并按前面的方式复查路由。

长期使用可做日志轮转,或将 plist 中的 RUST_LOG 改成 warn。修改 plist 后要重新载入,单独 kickstart 不会重新读取 plist。排查问题时再恢复查询日志。

1
2
3
4
5
# 只重启进程
sudo launchctl kickstart -k system/org.localdns.kixdns
# 修改 plist 后重新载入
sudo launchctl bootout system/org.localdns.kixdns
sudo launchctl bootstrap system /Library/LaunchDaemons/org.localdns.kixdns.plist

停用服务前先恢复 DNS。本机 Wi-Fi 原先使用网络下发的地址,可用下面的命令恢复;原先有手动 DNS 的机器要填回旧地址。曾经配置过域名专用 DNS 的机器,也要恢复或移除仍指向本地服务的规则。

1
2
3
sudo networksetup -setdnsservers "Wi-Fi" Empty
sudo dscacheutil -flushcache
sudo killall -HUP mDNSResponder

参考
关注公众号 尹安灿

引言

老东家的大佬基础架构方面做得比较好,日志打印都比较规范,还封装了日志组件,打印的日志不落盘,直接往 Kafka 送。

这样日志收集就省了很多事情了,性能还好。

健康160就没这么好条件了,因为项目庞大,建设时间跨度很长,技术架构迭代过几次,导致有很多不同语言,不同框架的服务。日志打印也是五花八门。

在开始推进Kubernetes容器化的时候,无可避免地要涉及日志的收集,真正收集的时候,才感觉这五花八门的日志采集起来,有点难受。

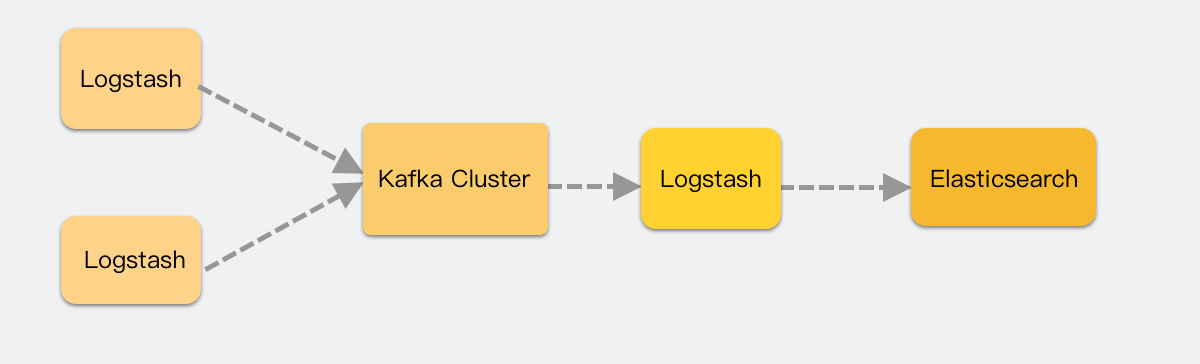
我们虚拟机方案是每个服务都配置一下 Logstash 来采集和过滤消息,然后推送到 Kafka 消费。

虚拟机日志流向

每个服务都要修改一下,来适配这个服务,这种刀耕火种的方式,感觉已经和时代脱轨了。我所期待的,是服务发到 k8s 后,就自动完成了日志的采集,不用配置 Logstash 了。加上 Logstash 是 Java 服务,资源占用不小,所以就把眼光瞄向基于 Fluent Bit的 日志Operator。

初探基于 FluentBit 的日志采集Operator

容器化的服务,我们会把日志输出到 stdout,而这些日志,会被容器收集起来放在/var/log/containers/*.log,所以我们只需要收集容器目录的日志就好。

基于 Fluent Bit 来做的 Kubernetes 日志采集的方案中,以 Fluent Operator 和 Logging Operator 最好。

它们默认都是用 Fluentbit 以 Deamonset形式部署,每个容器运行起来后,把宿主机的 /var/log/containers/ 目录挂进来,用 File Input 插件对该目录下的文件进行采集。

当时两个都支持 Fluent Bit 和 fluentd,都差不多。反而 Fluent Operator 的开箱即用做得更好些,基本 helm 简单配置下 values,安装就能用,Logging Operator 还需要一些额外的资源定义的配置才行。

于是就有了这篇文章:K8S日志收集 Fluent Operator 动态索引名的实现 当时还提了两个 PR 来支持这个改动 #1119 #1121

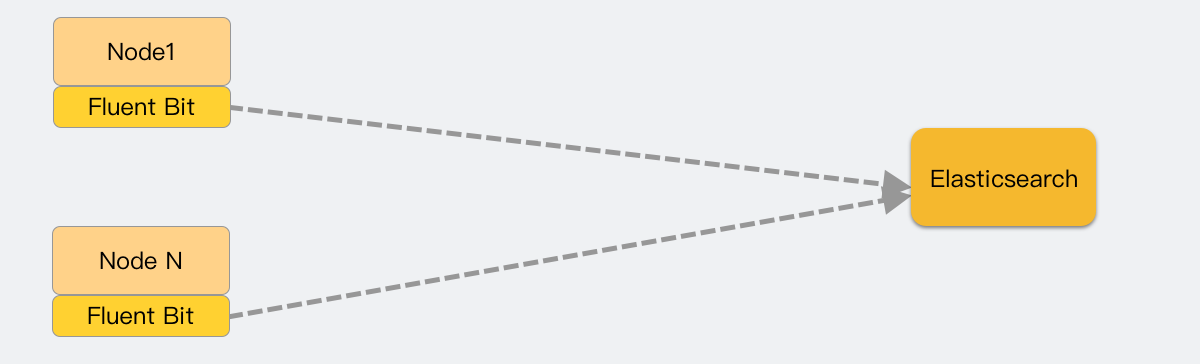
这时候采集大概是这样的,没有中间商赚差价。

k8s 日志流向 1

一开始,小日子看起来还是可以的,fluentbit 负载并不高,常年内存使用在 50mb 左右。

初遇挑战

异常堆栈多行文本合并问题

直到开发反馈说多行堆栈的内容没有合并到同个日志开始,幸福的日子就开始告一段落了。

堆栈日志

于是开始动手,增加了Java MultilineParser 来匹配日志 见这个 PR #1138 ,并顺手修复了没有用匿名结构体,导致生成的资源配置和 CRD 定义的资源不一致的bug MultilineParser achieve an effect similar to embedding by using anonymous structs #1133

经过折腾,发现能采集日志,而且多行采集也没问题,就应用了这个改动。

image-20240719192108605

日志采集暂停问题

没过几天,发现有些节点的日志采集停了,服务没日志了。再看该节点上的 Fluent Bit,相关节点内存占用都比较高,都到了分配的内存最高位。

看 Fluent Bit 的日志,发现

1
[ warn] [input] emitter.59 paused (mem buf overlimit)

当时 buffer 我用的是 memory,而不是 file,其实生产应该用 file 更好,可以分配更大的 buffer,而不用占用昂贵的内存。

想着内存不够,那就加多点,毕竟有时候输入过快,输出速度跟不上是很正常的,先提高内存来解燃眉之急。

回过头来,梳理了下,Fluent Bit buffer 消耗过多,猜测可能会以下几种情况:

  1. 高峰期消息生产实在太快,需要缓存来削峰,停过这段时间即可。
  2. multiline 匹配行还没遇到结束的 flag 的时候,要内存来保存,而大量的多行导致内存占用升高。
  3. 输出到 Elasticsearch 的速度过慢,无法及时消耗 input 的内容,导致内存堆高。

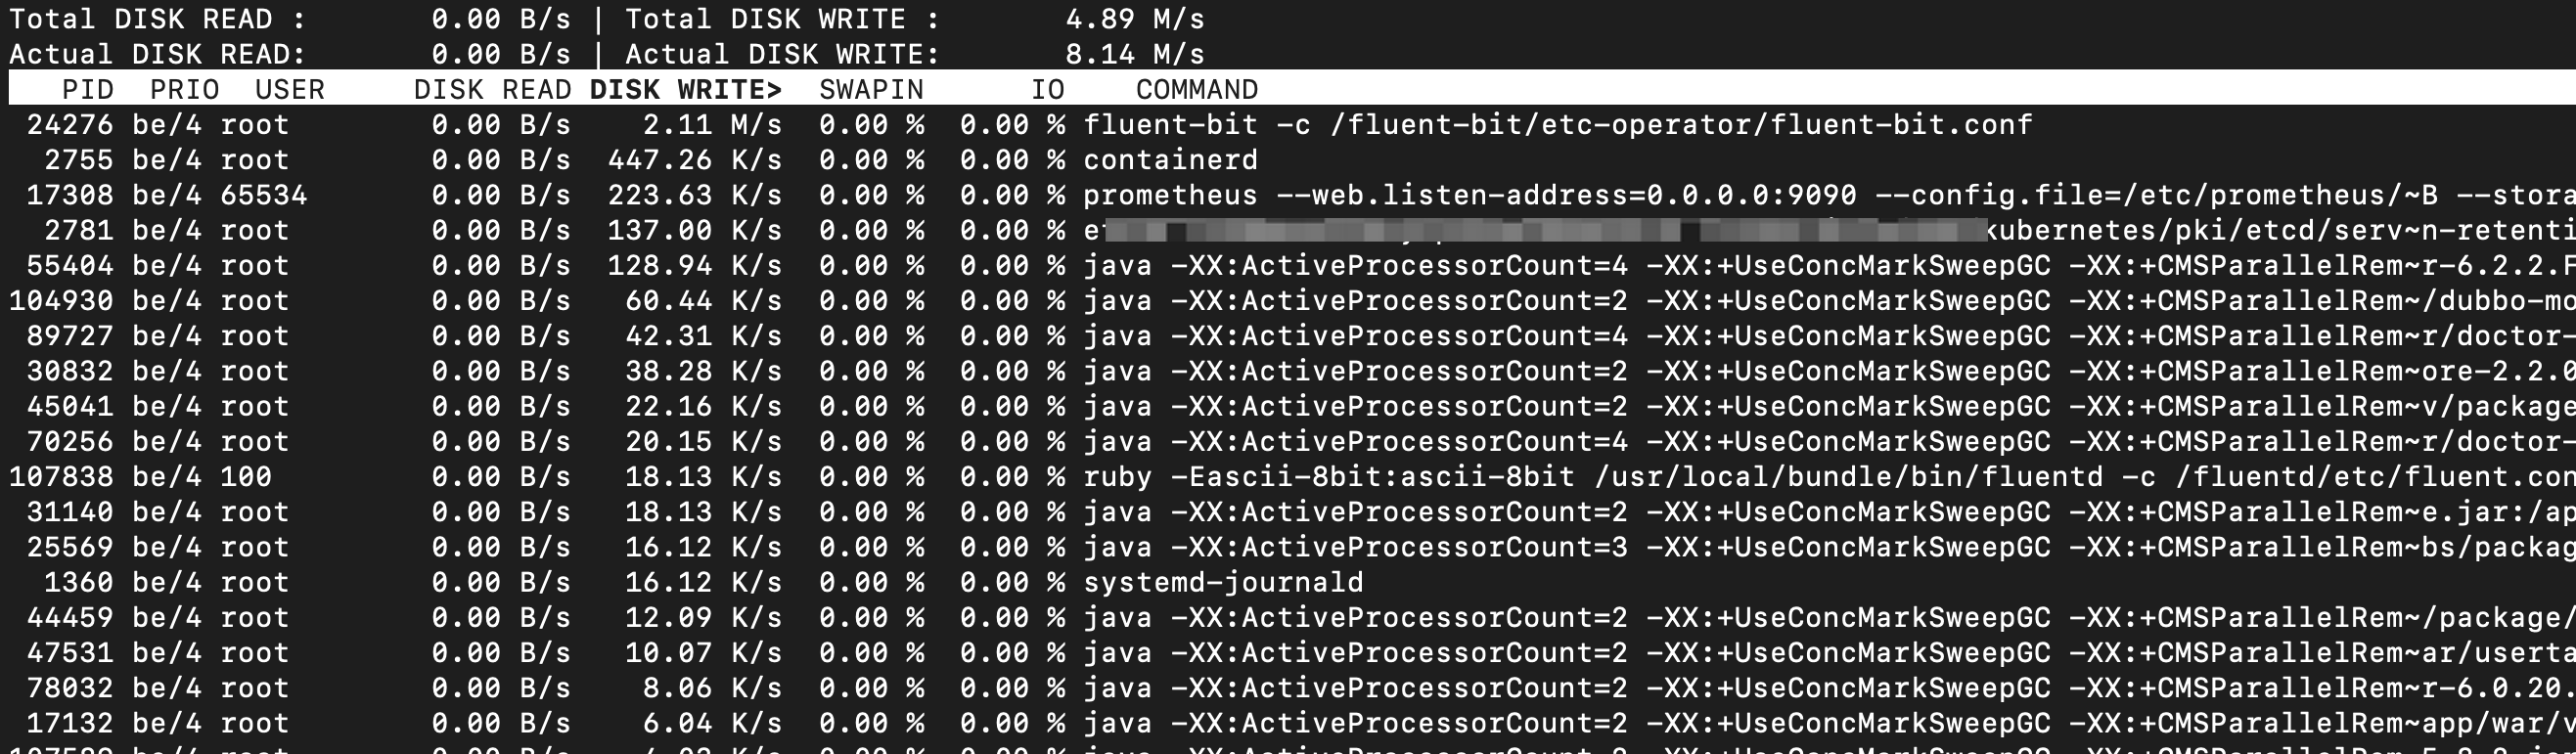
通过iotop -Po 只看进程,并且有 io 的进程,然后箭头左右控制,切换到 DISK WRITE 列 来观察,锁定一些输出高的进程。类似下面这样。

image-20240722113001898

发现在出问题的几台机器,有新容器化项目在运行,输出的日志量是比较多,明显大于其它的机器。

而 multiline 插件的memory buffer 确实会导致内存升高。而且我们多语言环境,有些语言框架输出的多行文本和别人的不太一样,很难有一套正则能涵盖所有语言的多行的起始匹配,可能会导致超长 multiline 的产生。

当时用的 fluent-bit 2.2.2版本,不会因为 buffer 满,而限流输入端,可能还导致日志丢失。见 Issue https://github.com/fluent/fluent-bit/issues/8198 , 3.0.2之后是会限流输入端的。

再看 Fluent Bit 的日志,会发现一些推送到 Elasticsearch 429 状态的日志,基本就是 Elasticsearch 太过于繁忙,日志推送被 reject了,需要重试。

调整方案

至此,问题四面八方都有,四面楚歌,痛定思痛,唯有重新梳理流程,调整日志采集的架构的路子可以走了。

需求整理

整理了下需求如下:

  1. 能监控采集的服务,及时发现采集端的问题。
  2. 能图表化看到采集组件的各项指标,好确定调整是否有效果。
  3. 比较方便地分类服务,按类别应用不同的语言的采集规则。
  4. 提升推送吞吐量,避免日志积压在推送端。

采集流程调整

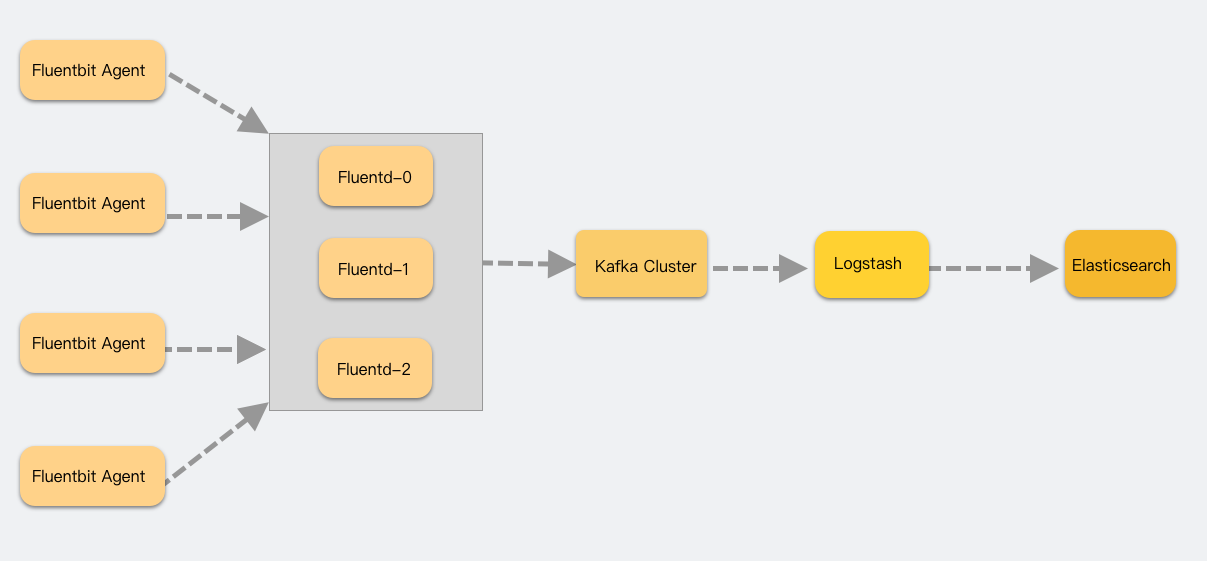
参考之前虚拟机的方案,调整后的架构如下:

新的日志架构

为什么搞了一个 fluentd 组出来?

主要是想减轻 FluentBit agent 的负载,FluentBit将其作为一个 demonset 的类型服务,一个节点有一个,如果它承担 Input 之外,还承担Filter 和 Output 的职责,很容易出现性能问题。而这个时候不好横向扩张来解决。

虽然可以做到为每个不同服务分组都建立一个 daemonset 的 FluentBit agent,来实现每台机有多个 agent 来处理,但是在现阶段下,一个节点一个 agent 来处理所有的日志 Input是没问题的。

Fluentbit 采集的日志,简单的 Parser 处理后,就直接 Forward 给 Fluentd 的service。fluentd 在这里用的是 StatefulSet类型,因为 buffer,cache之类的持久化存储,为了性能,使用的是 hostPath。

在 filter 和 output 遇到瓶颈的时候,是可以比较容易扩容来实现更高的数据处理的能力的。

日志采集Operator再选型

有了大致的方案和需求,就重新对社区的相关日志方案选型

能力 Fluent Operator Logging Operator
支持 fluent+fluentd方案 ✔ ✔
有开箱即用的 grafana 面板 ✖ ✔
比较方便地分类服务,使用不同的采集规则 ✖ ✔

两个其实差别不大,但是在我额外关注的点上,Logging Operator 要做得更好点。有 CNCF 的孵化,还是有后劲更足些。

Logging Operator有个抽象得不错的资源叫 Flow,可以比较轻松来根据 label 匹配不同的 pod 的日志进行采集。这在后续我区分不同的服务来用不同的规则的时候,起到很大的便利。

举个例子,我要匹配出label language=python 的服务进行使用detectExceptions 插件、record_transformer插件、record_modify 插件处理后,output 到 kafka 的相关 output 的时候,大概如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
apiVersion: logging.banzaicloud.io/v1beta1
kind: Flow
metadata:
name: python-kafka-flow
namespace: prod
spec:
match:
- select:
labels:
language: "python"
# - exclude:
# labels:
# swck-java-agent-injected: "true"
filters:
# - tag_normaliser: 这标签和detectExceptions 互斥
# format: ${kubernetes["labels"]["app"]}
- detectExceptions:
multiline_flush_interval: "0.1"
force_line_breaks: true
languages:
- python
# keep keys
- record_transformer:
enable_ruby: true
records:
- app_name: ${record["kubernetes"]["labels"]["app"]}
- ip: ${record["kubernetes"]["annotations"]["cni.projectcalico.org/podIP"]}
# clean keys
- record_modifier:
remove_keys: stream,logtag,kubernetes

localOutputRefs:
- kafka-output

有了 match,就可以针对不同的服务,使用不同的规则来精准匹配日志。

这里值得提醒的是,Fluentd的 filter 使用的插件越多,处理速度就越慢。比如上面的 detectExceptions 服务就迫使 Fluentd 只能工作在单 worker 模式下,性能大打折扣。

改动小结

让我们再总结一下。

之前的方案,所有的日志都用同一套采集规则,不够灵活。经过整改后我按照语言的维度来划分不同的 Flow,来应用不同的采集规则。

Buffer 和 Cache 从 Memory 改为 File,使用 hostPath 挂载的本地盘,保障写入的性能。

另外 Fluentbit 只承担 Input 和简单的 Parser任务,复杂和性能损耗比较大的 Filter 和耗时的推送交给 可以横向扩容的Fluentd。

Output 原先是直接推送到 ES集群,现在改为推送到 Kafka 集群,我对 Kafka 集群进行了基准测试,写入能力大概在 200mb/s 这个大大超出了我们的output 的流量,哪怕是高峰时期。

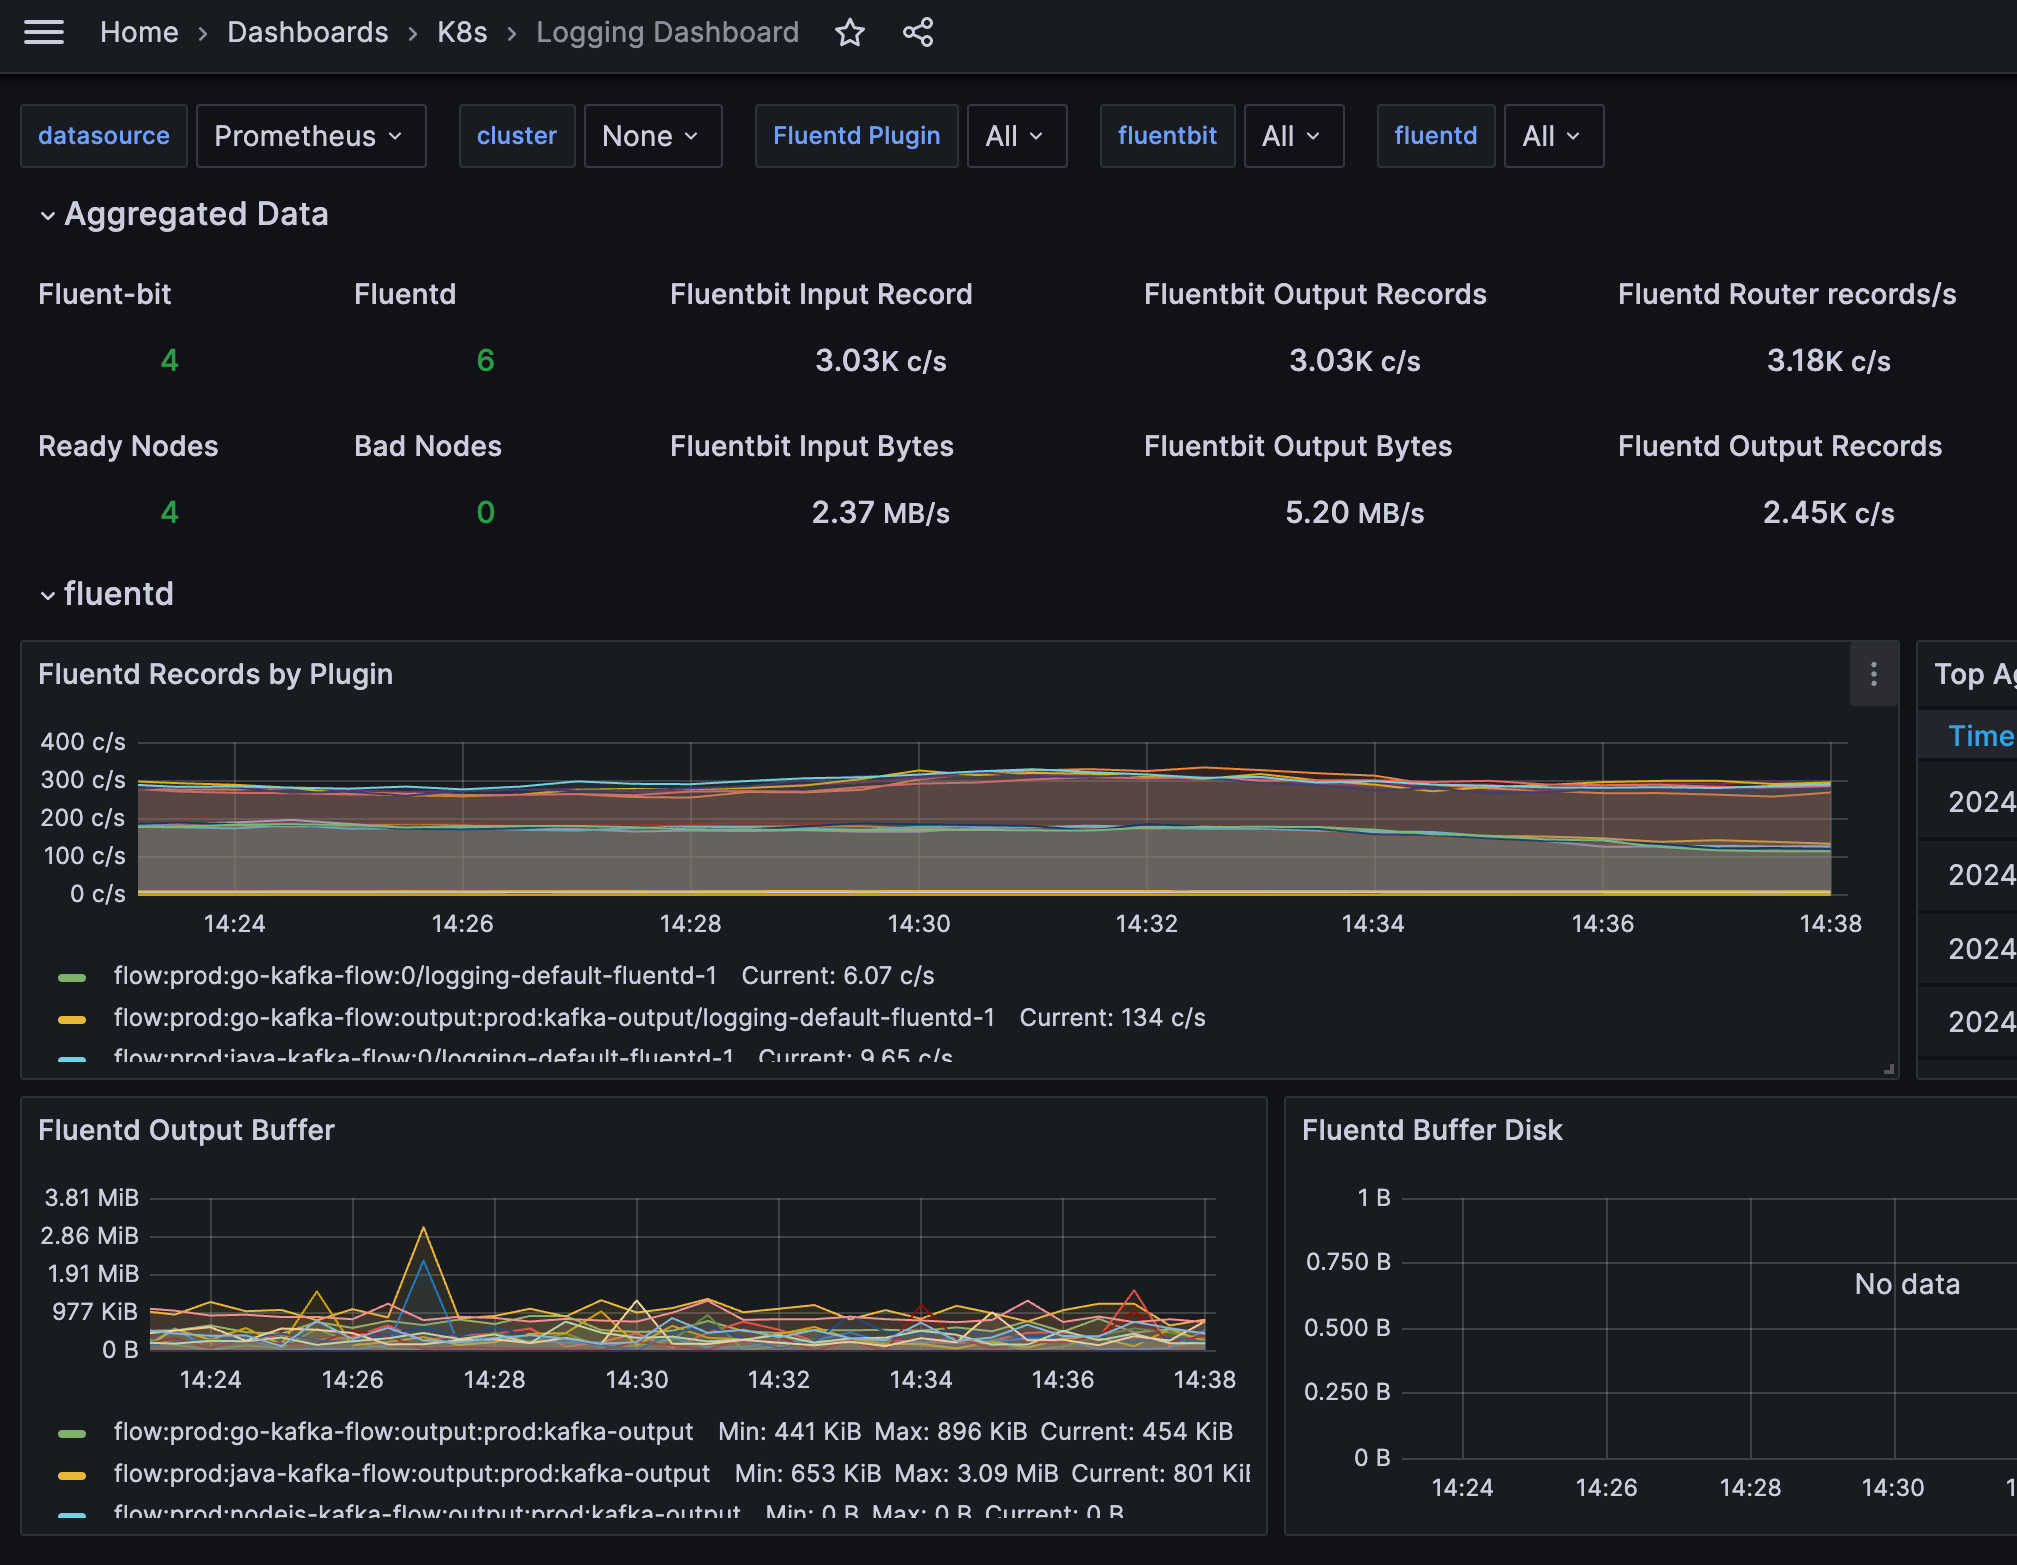
另外我们对 Fluentbit 和 Fluentd 的指标进行采集,并通过 Grafana 展示,容易一目了然观测过去和当下的日志采集情况。

图表示例

这样一来,职责清晰,也有较大的弹性来应对未来的流量暴涨。

掐指一算,妥妥的,然而…

新的挑战

Output Buffer 存满

然而在我认为最不可能发生问题的环节,偏偏发生了。Output 到 Kafka 的吞吐量,居然还不如之前的 Elasticsearch!

Output Buffer 很快就又堆满了。

经过排查,发现是 Logging Operator Fluentd内置的 Kafka 插件,默认用的是 ruby-kafka,性能非常差。可以改为用 rdkafka,这个是 c 语言实现的插件,性能比 ruby-Kafka 好很多。

我用的 Logging Operator 当前最新版本是 4.8.0,其用的 fluend:v1.16-4.8-full 镜像没有打包 rdkafka,另外 Logging Operator 并不支持 rdkafka 客户端的相关配置。

问题解决

知道了问题,就好解决了,我从新打包了一个镜像,把 rdkafka 打包进去,并修改了下 Logging Operator Kafka output支持该插件配置,并兼容之前的配置。

相关改动,我也提交到了社区,并被采纳了,不出意外的话,在 4.9.0 版本就可以体验。

具体 PR 见fluentd-images#/142 、logging-operator#1780

启用rdkafka client也非常简单,在原来的Kafka output 配置上增加 use_rdkafka: true 如

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
apiVersion: logging.banzaicloud.io/v1beta1
kind: Output
metadata:
name: kafka-output
namespace: mirr
spec:
kafka:
use_rdkafka: true #这句开启 rdkafka
brokers: 10.1.2.206:9092
default_topic: k8s-logs
format:
type: json
buffer:
tags: k8s-logs
timekey: 1m
timekey_wait: 30s
timekey_use_utc: true

效果

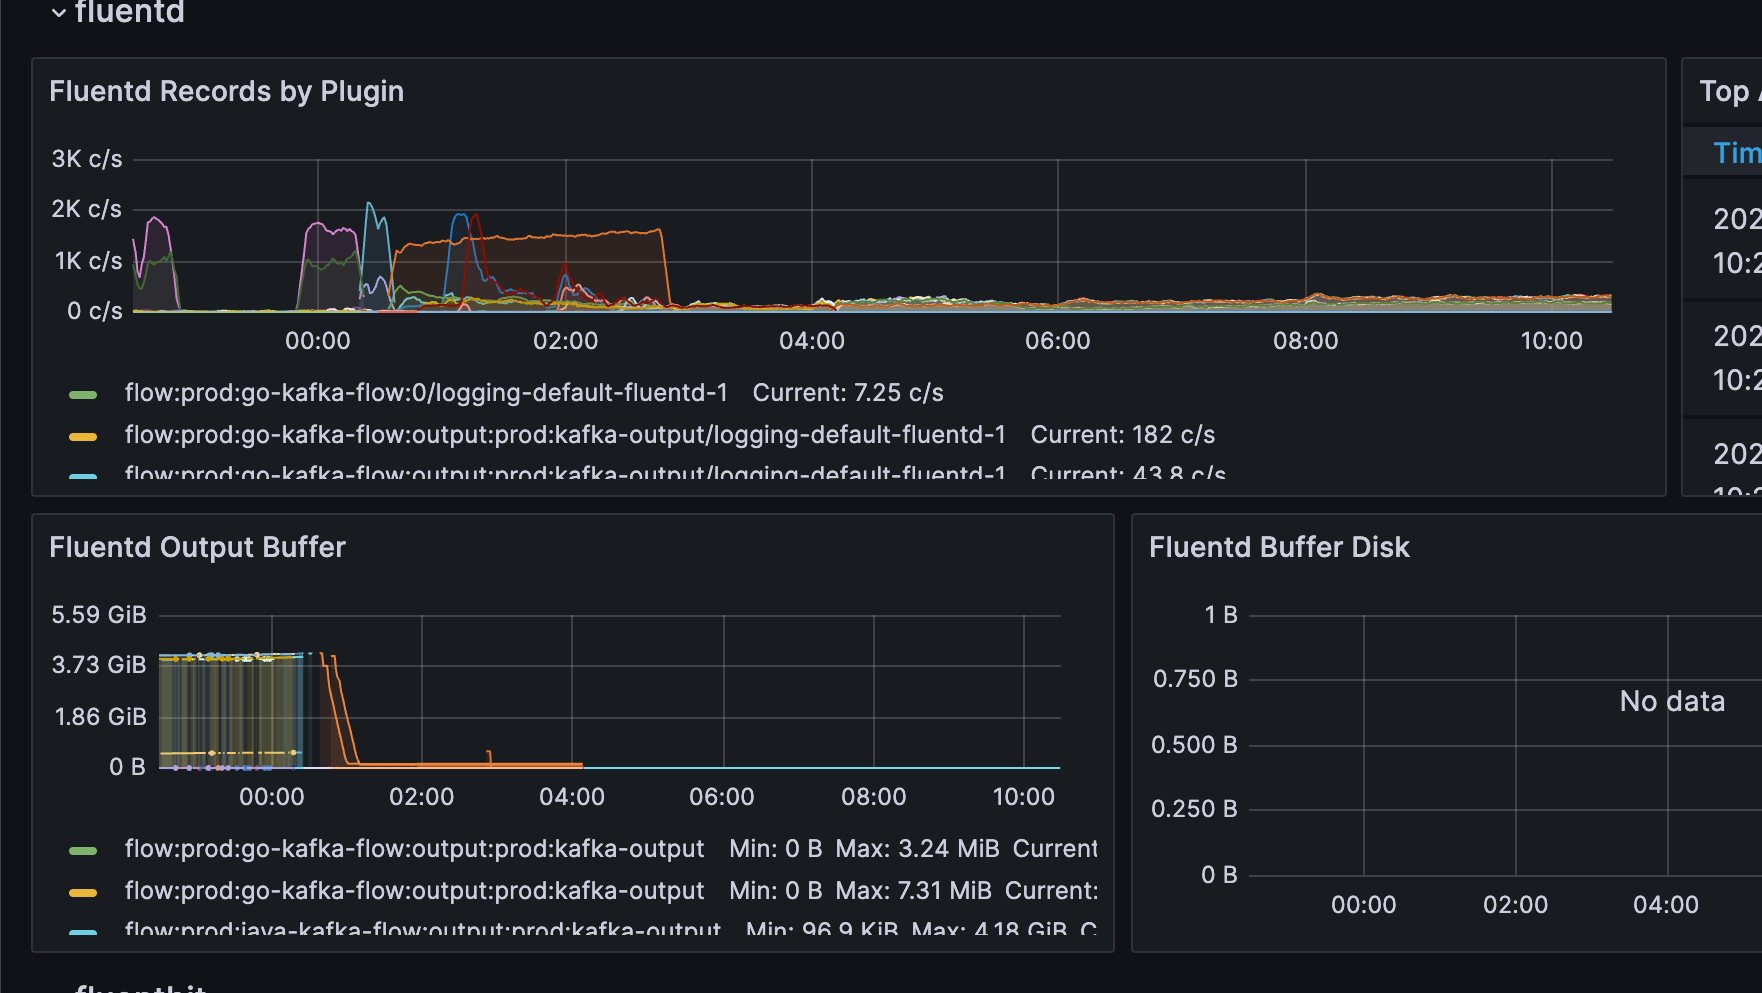
效果也是非常好,如下图 Output Buffer 的图表,之前 Buffer 到接近 4g(我分配的 Cache 大小就是 4g),在改动应用后,迅速就被消费完了。

截止今日,一个多星期了,依然没有遇到性能瓶颈。

image-20240710103011905

总结

我考察了基于Fluent Bit的Kubernetes日志采集方案,最终在Fluent Operator和Logging Operator之间,选择了Fluent Operator,因为它的开箱即用体验做得更好。

初次实施后,尽管Fluent Bit表现稳定,但我遇到了多行日志合并和日志采集暂停的问题,这让我不得不重新思考解决方案。

我决定将日志处理流程分解,让Fluentbit仅负责日志的采集和简单解析,而将过滤和输出任务交给Fluentd处理,同时通过Kafka作为中介,大幅提高了日志处理的效率和系统的稳定性。

在进一步优化过程中,我重新审视了日志框架的选择,最终决定采用Logging Operator,因为它在我关注的几个方面表现更佳,比如服务个性化配置方面和监控能力。

我根据服务的语言维度来划分不同的Flow,并应用不同的采集规则,这使我能更灵活地管理日志采集流程。

然而,当我将日志输出到Kafka时,又遇到了新的挑战:内置的Kafka插件性能不佳。

为解决这个问题,我自定义了镜像,将Fluentd的Kafka插件替换成性能更强的rdkafka,并成功地向Logging Operator社区提交了这一改进。

这一改动大大提高了日志推送到 Kafka的效率,让整个架构运行得更加顺畅。

最后,希望大家不要忽略了基础架构的标准化建设,统一有时候确实能在方方面面提升效率。

关注公众号 尹安灿

集群Service IP 段变更后(从 10.96.0.0/16 变为 10.17.0.0/16),导致 kubernetes.default.svc 的ClusterIP IP (10.96.0.1)和段范围不一样,对于这个情况,需要重建该 svc。

重建方法很简单,删除该 Service,集群会自动创建一个新的,ClusterIP 为 10.17.0.1 的 service。但是如果你和我一样直接这样操作,那大概率会遇到和我一样的坑。

这个是 集群内的服务访问apiserver 的主要方式。这个时候,几乎集群内需要和 apiserver 交互的功能和服务都不能正常使用。因为它们还是要和以前的 Service IP 进行通讯。

比如 calico-node 就开始出现问题、如创建销毁 pod的过程 要和calico-node通讯。一连串地炸了。

重建 apiserver 和 calico-node 后,发现 calico-node 起不来,发现它还是连接到老的 ClusterIP,于是修改它的环境变量指定正确的 Apiserver IP。

可以通过加入环境变量到 calico-node demonset 中,指定 IP 和端口

1
2
3
KUBERNETES_SERVICE_HOST:是k8s的kubernetes服务的serviceIP
KUBERNETES_SERVICE_PORT: 是k8s的kubernetes服务的端口号
KUBERNETES_SERVICE_PORT_HTTPS:是k8s的kubernetes服务的https端口号

于是编辑

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
kubectl edit daemonset calico-node -n kube-system
# 发现存在以下映射自 configmap 的环境变量kubernetes-services-endpoint,但是 configmap 并不存在
- configMapRef:
name: kubernetes-services-endpoint
# 我就没直接加到demonset里面,创建了对应的configmap
# 创建 ep.yaml 内容如下
apiVersion: v1
data:
KUBERNETES_SERVICE_HOST: 10.1.15.121
KUBERNETES_SERVICE_PORT: "6443"
KUBERNETES_SERVICE_PORT_HTTPS: "6443"
kind: ConfigMap
metadata:
name: kubernetes-services-endpoint
namespace: kube-system

kubectl apply -f ep.yaml

提交后calico-node 能顺利起来了,但是其它服务还是有问题。

上面 10.1.15.121 是我的 apiserver master 的 IP,为什么不写集群内的 Service ClusterIP 呢?当时改过为正确的新 IP,但是还是无法启动,因为证书里没含有新的集群 IP,然后就写这个了。证书当时每个 master 的 api 和负载均衡的域名都加进去了。

它正常后,pod 创建是没问题了,但是一些核心的服务还是有问题的。因为通过 Service 拿到的新 IP 10.17.0.1 不在 apiserver 的证书里面。

查看证书 SANs 命令

1
for i in $(find /etc/kubernetes/pki -type f -name "*.crt");do echo ${i} && openssl x509 -in ${i} -text | grep 'DNS:';done

于是到这一步就需要重新生成集群证书并把新 IP 加进去了。

以下是基于集群是 kubeadm 安装的前提

  1. 编辑 cm 加入

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    kubectl edit cm -n kube-system kubeadm-config
    ClusterConfiguration: |
    apiServer:
    certSANs:
    - 127.0.0.1
    - apiserver.cluster.local
    - 10.103.97.2
    - 10.1.15.121
    - 10.1.15.122
    - 10.1.15.123
    - 10.17.0.1
  2. 备份和删除本地证书

    1
    2
    3
    cp -r /etc/kubernetes /etc/kubernetes-bak
    rm -rf /etc/kubernetes/pki/{apiserver*,front-proxy-client*}
    rm -rf /etc/kubernetes/pki/etcd/{healthcheck*,peer*,server*}
  3. 生成新的证书

    1
    kubeadm init phase certs all --config kubeadmin-config.yaml
  4. 在每个 master node 重复 2~3 步骤

  5. 完成后,重建 apiserver 后 集群就正常了

总结

换 IP 段后,要及时生成新的 apiserver 的 Service ClusterIP 到证书 SANs 里。然后再重建 kubernetes.default.svc 。最后我把 kubernetes-services-endpoint configmap 的 IP 改为正确的 Service cluster IP 并重建了 calico-node。

关注公众号 尹安灿

解决 DNS conntrack 塞满 导致查询超时的问题

这个其实除了能解决 dns 塞满,还可以解决 ipv6 和 ipv4 并发解析, 落到同一个 coredns 的时候 conntrack 冲突导致丢包的问题。

IPVS 模式配置 node-local-dns

我们kube-proxy 用的是 IPVS mode

保存该文件 https://github.com/kubernetes/kubernetes/blob/master/cluster/addons/dns/nodelocaldns/nodelocaldns.yaml

内容如下:

registry.k8s.io/dns/k8s-dns-node-cache:1.23.0 建议保存替换成自己仓库的

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
# Copyright 2018 The Kubernetes Authors.
#
# Licensed under the Apache License, Version 2.0 (the "License");
# you may not use this file except in compliance with the License.
# You may obtain a copy of the License at
#
# http://www.apache.org/licenses/LICENSE-2.0
#
# Unless required by applicable law or agreed to in writing, software
# distributed under the License is distributed on an "AS IS" BASIS,
# WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
# See the License for the specific language governing permissions and
# limitations under the License.
#

apiVersion: v1
kind: ServiceAccount
metadata:
name: node-local-dns
namespace: kube-system
labels:
kubernetes.io/cluster-service: "true"
addonmanager.kubernetes.io/mode: Reconcile
---
apiVersion: v1
kind: Service
metadata:
name: kube-dns-upstream
namespace: kube-system
labels:
k8s-app: kube-dns
kubernetes.io/cluster-service: "true"
addonmanager.kubernetes.io/mode: Reconcile
kubernetes.io/name: "KubeDNSUpstream"
spec:
ports:
- name: dns
port: 53
protocol: UDP
targetPort: 53
- name: dns-tcp
port: 53
protocol: TCP
targetPort: 53
selector:
k8s-app: kube-dns
---
apiVersion: v1
kind: ConfigMap
metadata:
name: node-local-dns
namespace: kube-system
labels:
addonmanager.kubernetes.io/mode: Reconcile
data:
Corefile: |
__PILLAR__DNS__DOMAIN__:53 {
errors
cache {
success 9984 30
denial 9984 5
}
reload
loop
bind __PILLAR__LOCAL__DNS__ __PILLAR__DNS__SERVER__
forward . __PILLAR__CLUSTER__DNS__ {
force_tcp
}
prometheus :9253
health __PILLAR__LOCAL__DNS__:8080
}
in-addr.arpa:53 {
errors
cache 30
reload
loop
bind __PILLAR__LOCAL__DNS__ __PILLAR__DNS__SERVER__
forward . __PILLAR__CLUSTER__DNS__ {
force_tcp
}
prometheus :9253
}
ip6.arpa:53 {
errors
cache 30
reload
loop
bind __PILLAR__LOCAL__DNS__ __PILLAR__DNS__SERVER__
forward . __PILLAR__CLUSTER__DNS__ {
force_tcp
}
prometheus :9253
}
.:53 {
errors
cache 30
reload
loop
bind __PILLAR__LOCAL__DNS__ __PILLAR__DNS__SERVER__
forward . __PILLAR__UPSTREAM__SERVERS__
prometheus :9253
}
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
name: node-local-dns
namespace: kube-system
labels:
k8s-app: node-local-dns
kubernetes.io/cluster-service: "true"
addonmanager.kubernetes.io/mode: Reconcile
spec:
updateStrategy:
rollingUpdate:
maxUnavailable: 10%
selector:
matchLabels:
k8s-app: node-local-dns
template:
metadata:
labels:
k8s-app: node-local-dns
annotations:
prometheus.io/port: "9253"
prometheus.io/scrape: "true"
spec:
priorityClassName: system-node-critical
serviceAccountName: node-local-dns
hostNetwork: true
dnsPolicy: Default # Don't use cluster DNS.
tolerations:
- key: "CriticalAddonsOnly"
operator: "Exists"
- effect: "NoExecute"
operator: "Exists"
- effect: "NoSchedule"
operator: "Exists"
containers:
- name: node-cache
image: registry.k8s.io/dns/k8s-dns-node-cache:1.23.0
resources:
requests:
cpu: 25m
memory: 5Mi
args: [ "-localip", "__PILLAR__LOCAL__DNS__,__PILLAR__DNS__SERVER__", "-conf", "/etc/Corefile", "-upstreamsvc", "kube-dns-upstream" ]
securityContext:
capabilities:
add:
- NET_ADMIN
ports:
- containerPort: 53
name: dns
protocol: UDP
- containerPort: 53
name: dns-tcp
protocol: TCP
- containerPort: 9253
name: metrics
protocol: TCP
livenessProbe:
httpGet:
host: __PILLAR__LOCAL__DNS__
path: /health
port: 8080
initialDelaySeconds: 60
timeoutSeconds: 5
volumeMounts:
- mountPath: /run/xtables.lock
name: xtables-lock
readOnly: false
- name: config-volume
mountPath: /etc/coredns
- name: kube-dns-config
mountPath: /etc/kube-dns
volumes:
- name: xtables-lock
hostPath:
path: /run/xtables.lock
type: FileOrCreate
- name: kube-dns-config
configMap:
name: kube-dns
optional: true
- name: config-volume
configMap:
name: node-local-dns
items:
- key: Corefile
path: Corefile.base
---
# A headless service is a service with a service IP but instead of load-balancing it will return the IPs of our associated Pods.
# We use this to expose metrics to Prometheus.
apiVersion: v1
kind: Service
metadata:
annotations:
prometheus.io/port: "9253"
prometheus.io/scrape: "true"
labels:
k8s-app: node-local-dns
name: node-local-dns
namespace: kube-system
spec:
clusterIP: None
ports:
- name: metrics
port: 9253
targetPort: 9253
selector:
k8s-app: node-local-dns

安装:

169.254.20.10 写死用这个杜撰的 IP即可,生产和镜像都一样

1
2
3
4
5
kubedns=`kubectl get svc kube-dns -n kube-system -o jsonpath={.spec.clusterIP}`
domain="cluster.local"
localdns="169.254.20.10"
sed -i "s/__PILLAR__LOCAL__DNS__/$localdns/g; s/__PILLAR__DNS__DOMAIN__/$domain/g; s/,__PILLAR__DNS__SERVER__//g; s/__PILLAR__CLUSTER__DNS__/$kubedns/g" nodelocaldns.yaml
kubectl apply -f nodelocaldns.yaml

验证:

进入一个 pod,把/etc/resolv.conf 的 name server 改为169.254.20.10。然后 nslookup 看服务和其它域名解析正常即可。

配置 DNS优先使用 node-local-dns

主要有两种:

1. 全局生效,修改 kubelet 指定的 cluster dns

1
2
3
4
5
6
7
8
9
10
11
12
kubedns=`kubectl get svc kube-dns -n kube-system -o jsonpath={.spec.clusterIP}`
sed -i "s/$kubedns/169.254.20.10/g" /var/lib/kubelet/config.yaml
# --
# 验证 改为 169.254.20.10 了
# cat /var/lib/kubelet/config.yaml|grep -A 3 DNS
#clusterDNS:
#- 169.254.20.10
#clusterDomain: cluster.local
#configMapAndSecretChangeDetectionStrategy: Watch
# ---
systemctl restart kubelet
systemctl status -l kubelet

2.在 pod 的 dnsConfig 指定

1
2
3
4
5
6
7
8
9
10
11
dnsConfig:
nameservers:
- 169.254.20.10
searches:
- test.svc.cluster.local
- svc.cluster.local
- cluster.local
- nykjsrv.cn
options:
- name: ndots
value: '5'

参考

关注公众号 尹安灿

在单台 Nginx 负载能力冗余的情况,没必要申请更多资源做负载均衡,只需要保障高可用即可。 此配置为了应对 nginx单台机器 崩溃,或者重启 导致服务不可用的时候,能自动切换到备用的 nginx。两台 nginx 理应部署在不同的物理机,避免物理机重启的时候彻底不可用。

根据目前医院情况,Nginx 有两台,分别是 100.100.100.245 和 100.100.100.247,那寻找一个还未被使用的同网段 ip,这里假设是 100.100.100.246 还未被使用。 未禁止 ping 的时候 ping 100.100.100.246 是没有回应的。

那目前我们掌握的IP信息大概如下:

- Nginx master: 100.100.100.245

- Nginx slave: 100.100.100.247

- Virtual IP(VIP): 100.100.100.246

配置Keepalived

在Nginx master: 100.100.100.245 配置

执行以下命令安装 keepalived

1
yum install -y keepalived

配置 nginx 健康检查脚本。该脚本主要实现以下功能

  1. 如果不存在 nginx 进程,则尝试启动 nginx 进程。这里我们是用 systemd 管理的 nginx,所以用 systemctl start nginx ,如果是别的方式启动,请写具体的启动命令。
  2. 如果依然启动失败 则杀死 keepalived 进程 使得 VIP 立马飘走。不用等待权重慢慢减少再飘走。
1
2
3
4
5
6
7
8
9
10
11
cat <<EOF> /usr/local/src/nginx_check.sh
#! /bin/bash
A=`ps -C nginx --no-header | wc -l`
if [ $A -eq 0 ];then
systemctl start nginx
sleep 2
if [ `ps -C nginx --no-header| wc -l` -eq 0 ];then
killall keepalived
fi
fi
EOF

配置 keepalived

以下脚本注意修改以下几个点

  • 网卡设备名 我这里是 eth0 ,可以使用 ip a 这个命令查看,如果不是 eth0,则修改 interface 后面的 eth0 为你正确的设备名。
  • VIP 我们前面选定的 VIP 是 100.100.100.246
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
cat <<EOF> /etc/keepalived/keepalived.conf 
global_defs {
router_id LVS_Main
}

vrrp_script chk_nginx {
script "/usr/local/src/nginx_check.sh"
interval 2
weight 2
}

vrrp_instance VI_1 {
state MASTER
interface eth0
virtual_router_id 160
priority 100
advert_int 1
authentication {
auth type PASS
auth pass 1111
}
track_script {
chk_nginx
}
virtual_ipaddress {
100.100.100.246/24
}
}
EOF

启动 keepalived 并设置开机启动

1
systemctl enable --now keepalived

在 Nginx slave: 100.100.100.247 配置

执行以下命令安装 keepalived

1
yum install -y keepalived

配置 nginx 健康检查脚本

1
2
3
4
5
6
7
8
9
10
11
cat <<EOF> /usr/local/src/nginx_check.sh
#! /bin/bash
A=`ps -C nginx --no-header | wc -l`
if [ $A -eq 0 ];then
systemctl start nginx
sleep 2
if [ `ps -C nginx --no-header| wc -l` -eq 0 ];then
killall keepalived
fi
fi
EOF

配置 keepalived

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
cat <<EOF> /etc/keepalived/keepalived.conf 
global_defs {
router_id LVS_Slave
}

vrrp_script chk_nginx {
script "/usr/local/src/nginx_check.sh"
interval 2
weight 2
}

vrrp_instance VI_1 {
state SLAVE
interface eth0
virtual_router_id 160
priority 10
advert_int 1
authentication {
auth type PASS
auth pass 1111
}
track_script {
chk_nginx
}
virtual_ipaddress {
100.100.100.246/24
}
}
EOF

启动 keepalived 并设置开机启动

1
systemctl enable --now keepalived

检查配置效果

确认两台机的 nginx 和 keepalived 都启动

1
2
systemctl status nginx
systemctl status keepalived

检查当前 VIP 是否绑定

目前 master (100.100.100.245)的priority 比较高,所以用命令 ip a 查看的时候,能看到VIP(100.100.100.246) 被绑在对应的网卡

1
ip a

nginx 停止的时候能被 keepalived 再度拉起

1
2
3
systemctl stop nginx
# 过几秒再查看 nginx 是否有启动
systemctl status nginx

测试 VIP 是否能飘走

1
2
3
4
5
6
7
# 在master
systemctl stop keepalived
# 停止后 看VIP是否没有了
ip a

# 在slave上查看 VIP 是否绑定
ip a

注意事项

  • 修改配置后一定要 ·nginx -t· 测试没问题后再 reload
  • 理应注意两台机器的配置保持同步。

简单点的话,在配置了 ssh master 上免密登录 slave 后。可以采用 rsync 命令同步配置

1
2
3
rsync -avz --delete /etc/nginx/ user@100.100.100.247:/etc/nginx/
# 重载 slave nginx 配置
ssh root@100.100.100.247 'systemctl reload nginx'

关注公众号 尹安灿

兄弟们,我又来亏钱了

今天介绍亏钱工具 freqtrade macos 下的安装

下载 freqtrade

1
git clone https://github.com/freqtrade/freqtrade.git

安装并激活python 环境

1
2
conda create --name freqtrade python=3.11
conda activate freqtrade

安装依赖

1
2
3
4
./build_helpers/install_ta-lib.sh
python3 -m pip install --upgrade pip
python3 -m pip install -r requirements.txt
python3 -m pip install -e .

测试

1
2
3
4
5
> freqtrade create-userdir --userdir user_data
2024-02-28 18:28:45,361 - freqtrade - INFO - freqtrade 2024.3-dev-d1028b8ca
2024-02-28 18:28:45,362 - freqtrade.configuration.directory_operations - INFO - Created user-data directory: user_data

# 能看到这个输出 基本问题不大 可以准备亏钱之旅了

安装文档

https://www.freqtrade.io/en/stable/installation/#freqtrade-install-conda-environment

关注公众号 尹安灿

近日有需求对 es 进行基准测试,来和华为云的产品来做个横向对比。简单记录下过程,以便未来能复用。

本次测试主要横向对比本地的机器、华为云 CSS、华为云上自建 ES 集群的性能。

系统均基于 centos7.x

Esrally初始化

安装 python3.9

1
2
3
4
5
6
7
yum install conda
conda create -n py39 python=3.9
conda init bash
## conda 初始化 bash 后 要 relogin 一次
conda activate py39
yum install pbzip
python3 -m pip install --user esrally

安装高版本git

esrally 有些操作依赖 git 来 fetch 它自己的一些资源

1
2
3
yum remove git-*
yum install https://packages.endpointdev.com/rhel/7/os/x86_64/endpoint-repo.x86_64.rpm
yum install git

离线下载好要准备的 track

为了不在测试开始的时候 在网络上耗费太多时间在等待下载测试数据,所以推荐先离线下载好相关数据。

1
2
3
4
5
6
7
8
9
10
esrally list tracks
# 列出可用的 tracks
这里选华为云给出的 benchmark 数据所用的数据集 geonames
curl -O https://raw.githubusercontent.com/elastic/rally-tracks/master/download.sh
chmod a+x download.sh
./download.sh geonames
tar -xf rally-track-data-geonames.tar
# 这就离线好了
ll ~/.rally/benchmarks/tracks/default/geonames/
# 可以查看track 的内容

esrally一些实用的用法

1
2
3
4
5
6
7
8
9
10
# 对已存在的集群进行 benchmark 并调整测试的索引分片数为 6 保存结果到 race.md --track-params 可以修改 track 参数 覆盖默认值
nohup esrally race --track=geonames --pipeline=benchmark-only --target-hosts=10.8.58.101:9200,10.8.58.102:9200,10.8.58.103:9200 --track-params="number_of_shards:6" --challenge=append-no-conflicts --on-error=abort --report-file=~/race.md > race.log &

# 对比两次 race 的结果
esrally list races
esrally compare --baseline a64a2e46-9cf9-4961-9cee-d793608c9de8 --contender ee79d74e-83ad-4124-9a2b-e902d742b387

# 如果在不同的机器进行的基准测试,想在一台机上对比
ll .rally/benchmarks/races/
把这个目录下对应的 race 的文件夹 拷贝到同个机器这个目录就可以了。

常见问题

有时候结果中并没有出现 ·index-append· 的数据,可以更改 ~.rallly/benchmarks/tracks/default/<对应的 track>/challenges/default.json index-append warmup-time-period 的值,从120 调整为 20

如 geonames track 的

1
2
3
4
5
6
7
8
vim ~/.rally/benchmarks/tracks/default/geonames/challenges/default.json
...
{
"operation": "index-append",
"warmup-time-period": 20,
"clients": {{bulk_indexing_clients | default(8)}},
"ignore-response-error-level": "{{error_level | default('non-fatal')}}"
},
Read more »

关注公众号 尹安灿

日志收集,考虑到我们没有主动上报日志,格式也不太统一,容器化的时候,对于我们而言采集容器标准输出的日志是更快捷达到目的的方式。

大致对比了filebeat、fluentd、fluentbit、vector、logstash后,锁定了flientbit。

虽然它功能不是最强大的,但是基本功能能满足我们的业务需求,采集输入端多样化,也能做简单的filter,支持output的端也很丰富。其次,它吃资源比较少,性能也不错。

我们只需要它收集标准输出的日志,输出到es即可。

而在k8s中,有kubesphere共献给fluent的fluent-operator。该opeator提供了fluentbit only、fluentd only、fluentbit+fluentd 这几种采集方式。对于我们而言,就fluentbit 就够了。

我选择了helm方式安装,下载了它chart (https://github.com/fluent/fluent-operator/releases/download/v2.2.0/fluent-operator.tgz)包,解压到`/app/fluent-operator/ `,直接修改里面values.yaml,这样好方便未来管理自己的部署配置。

简单按照文档,修改了fluentbit的input和output后,直接安装即可

1
2
helm upgrade --install fluent-operator --create-namespace -n fluent /app/fluent-operator/ --set containerRuntime=containerd

按照服务名区分索引名

日志是能收集了,但是所有的服务的日志,当天都放到一个索引,类似 “k8s-logs-<yyyy.mm.dd>” 这样的索引中。本地还好,如果生产环境的话,那一天单个索引就十分庞大了。而且对于不同服务日志保留天数做差异化保留的时候也不好处理,也不好直观展示各个服务日志大小。

所以能按照k8s-<service-name>-<yyyy.mm.dd>格式的话,对我们会更为理想点。截止目前的版本,没有现成的配置可以实现这个。经过研究,可以利用fluentbit的 logstash_prefix_key 这个来实现。logstash_prefix是固定的前缀,logstash_prefix_key则可以动态读取 key来作为索引名。

1.修改fluent-operator,让其支持logstash_prefix_key

经过测试,fluent-operator当前版本的模板并没有对该字段进行处理,所以要进行修改让它支持这个字段。

我需要output到es,所以我就修改了es相关的output,其它输出源的可以自己检查下。

修改 ./templates/fluentbit-output-elasticsearch.yaml

在Values.fluentbit.output.es.logstashPrefix之后增加 .Values.fluentbit.output.es.logstashPrefixKey 这段的配置,如下:

1
2
3
4
5
6
{{- if .Values.fluentbit.output.es.logstashPrefix }}
logstashPrefix: {{ .Values.fluentbit.output.es.logstashPrefix | default "ks-logstash-log" | quote }}
{{- end }}
{{- if .Values.fluentbit.output.es.logstashPrefixKey }}
logstashPrefixKey: {{ .Values.fluentbit.output.es.logstashPrefixKey | default "ks-logstash-log-key" | quote }}
{{- end }}

2.让它能获取app name作为服务名

./values.yaml 修改fluentbit部分,开启kubernetes labels,因为labels的app标签就是我们的服务名。

1
2
3
4
5
6
filter:
kubernetes:
enable: true
labels: true


3. 拼接索引名

由于logstash_prefix_key只能接受 key,且不支持嵌套的对象的key。

举个直观的例子,假设你的对象是这样的:

1
2
3
4
5
6
7
8
{
"file": "systemd.log",
"kubernetes": {
"labels": {
"app": "demo-service"
}
}
}

像 k8s-$kubernets["labels"]["app"] 和 像 $kubernets["labels"]["app"] 这样的值,是取不到任何内容的。像上面的例子,只接受 $file 这个值。

所以这里要实现我们的目标,我们得自己拼接出一个新的key,作为索引名。类似下面:

1
2
3
4
5
6
7
8
9
{
"file": "systemd.log",
"app_name": "k8s-demo-service",
"kubernetes": {
"labels": {
"app": "demo-service"
}
}
}

我是这样实现的,利用lua的filter,通过取出kubernetes的labels,拼接新的值。

我修改的是 cat ./templates/fluentbit-containerd-config.yaml 增加了一个 add_k8s_app_name_field 函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
{{- if .Values.Kubernetes -}}
{{- if .Values.fluentbit.enable -}}
{{- if .Values.fluentbit.filter.containerd.enable -}}
apiVersion: v1
kind: ConfigMap
metadata:
name: fluent-bit-containerd-config
data:
containerd.lua: |
function containerd( tag, timestamp, record)
if(record["logtag"]~=nil)
then
timeStr = os.date("!*t", timestamp["sec"])
t = string.format("%4d-%02d-%02dT%02d:%02d:%02d.%sZ",
timeStr["year"], timeStr["month"], timeStr["day"],
timeStr["hour"], timeStr["min"], timeStr["sec"],
timestamp["nsec"]);
record["time"] = t;
record["log"] = record["message"];
record["message"] = nil;
return 1, timestamp, record
else
return 0,timestamp,record
end
end

function add_k8s_app_name_field(tag, timestamp, record)
retcode = 0
prefix = 'k8s'
app_name = record['kubernetes']['labels']['app']
if app_name ~= nil then
app_name = prefix .. '-' .. app_name

if app_name ~= nil then
record['app_name'] = app_name
retcode = 2
end
end

return retcode, timestamp, record
end
{{- end }}
{{- end }}
{{- end }}

修改 templates/fluentbit-clusterfilter-kubernetes.yaml 增加新增的lua filter函数 对kubernetes标签进行处理

cat templates/fluentbit-clusterfilter-kubernetes.yaml

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
{{- if .Values.Kubernetes -}}
{{- if .Values.fluentbit.enable -}}
{{- if .Values.fluentbit.filter.kubernetes.enable -}}
apiVersion: fluentbit.fluent.io/v1alpha2
kind: ClusterFilter
metadata:
name: kubernetes
labels:
fluentbit.fluent.io/enabled: "true"
fluentbit.fluent.io/component: logging
spec:
match: kube.*
filters:
- kubernetes:
kubeURL: https://kubernetes.default.svc:443
kubeCAFile: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
kubeTokenFile: /var/run/secrets/kubernetes.io/serviceaccount/token
{{- $params := omit .Values.fluentbit.filter.kubernetes "enable" }}
{{- if .Values.fluentbit.output.stdout.enable }}
{{- $_ := set $params "k8sLoggingExclude" true -}}
{{- end }}
{{- with $params }}
{{- . | toYaml | nindent 6 }}
{{- end }}
- lua:
script:
key: containerd.lua
name: fluent-bit-containerd-config
call: add_k8s_app_name_field
timeAsTable: true
- nest:
operation: lift
nestedUnder: kubernetes
addPrefix: kubernetes_
- modify:
rules:
- remove: stream
- remove: kubernetes_pod_id
- remove: kubernetes_docker_id
- remove: kubernetes_container_hash
- remove: kubernetes_labels
- nest:
operation: nest
wildcard:
- kubernetes_*
nestUnder: kubernetes
removePrefix: kubernetes_
{{- end }}
{{- end }}
{{- end }}

主要增加了

1
2
3
4
5
6
- lua:
script:
key: containerd.lua
name: fluent-bit-containerd-config
call: add_k8s_app_name_field
timeAsTable: true

到这里基本就满足所有的条件了,为了不影响systemd的日志收集和归类,也给它的lua filter增加app_name字段.

./templates/fluentbit-lua-config.yaml

1
new_record["app_name"] = "systemd"

经过前面的修改后,只要在values.yaml 设置 fluentbit.output.es.logstashPrefixKey=”$app_name” 即可

4. 应用变更

我修改过的values.yaml,去除了无关部分后主要如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
Kubernetes: true
fluentbit:
crdsEnable: true
enable: true
image:
repository: "hub.xxxx.com/library/fluent-bit"
tag: "v2.0.11"
input:
tail:
enable: true
refreshIntervalSeconds: 10
memBufLimit: 50MB
path: "/var/log/containers/*.log"
skipLongLines: false
systemd:
enable: true
path: "/var/log/journal"
includeKubelet: true
output:
es:
enable: true
# 如果多个host的话,用hosts
host: "es.xxx.local"
port: 9200
logstashFormat: true
logstashPrefixKey: "$app_name"
filter:
kubernetes:
enable: true
labels: true
annotations: false
k8sLoggingExclude: true
containerd:
enable: true
systemd:
enable: true

再来helm更新一下,搞定

1
helm upgrade --install fluent-operator --create-namespace -n fluent /app/fluent-operator/ --set containerRuntime=containerd

效果如下:

1
2
3
4
yellow open k8s-kiali-2023.05.10                iWEHK0gKR6GoPKjO3gH6Eg 1 1      30      0 105.9kb 105.9kb
yellow open k8s-nginx-deploy-2023.05.10 OCzPIKWgRneSn27J-o4k9g 1 1 16 0 76.3kb 76.3kb
yellow open k8s-istiod-2023.05.10 GlA1dI7aQDqPFD-5ZMX6iw 1 1 797 0 329.5kb 329.5kb
yellow open k8s-reviews-2023.05.10 41Ifiq3cTQGBKdJ4Fn2MJQ 1 1 18 0 86.6kb 86.6kb

关注公众号 尹安灿

背景是我们希望能在k8s中通过DNS方式,访问服务的FQDN来调用虚拟机注册到nacos的服务。

我们vm和k8s的网段配置了相关路由能相互访问

之前nacos有维护了一个同步去coredns的项目,但是年久失修,支持的nacos版本和coredns版本都不高。后面在官方文档找资料的时候,发现nacos是支持istio MCP协议的 Pilot MCP协议介绍,于是采取这个方案来完成目标。《Nacos 1.1.4发布,业界率先支持Istio MCP协议》

环境:

istio: 1.10

nacos: 2.1.0

配置nacos开启MCP Server

进入nacos配置目录,执行以下命令,把 nacos.istio.mcp.server.enabled 值设置为 true。重启nacos server 让它运行MCP Server。

1
[root@dev_10.1.10.209 nacos]#sed -i 's/nacos.istio.mcp.server.enabled=false/nacos.istio.mcp.server.enabled=true/g' conf/application.properties

重启后nacos MCP server会监听 18848 端口

1
2
3
[root@dev_10.1.10.209 nacos]#lsof -i:18848
COMMAND PID USER FD TYPE DEVICE SIZE/OFF NODE NAME
java 98108 root 171u IPv4 834348182 0t0 TCP *:18848 (LISTEN)

配置istio添加MCP server sources

我测试的nacos server所在的服务器IP10.1.10.209

nacos MCP server监听的端口 18848

编辑istio的configmap,添加以下配置

1
kubectl edit -n istio-system cm istio
1
2
configSources:
- address: xds://10.1.10.209:18848

添加后的配置大概如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
apiVersion: v1
data:
mesh: |-
accessLogFile: /dev/stdout
configSources:
- address: xds://10.1.10.209:18848
defaultConfig:
discoveryAddress: istiod.istio-system.svc:15012
proxyMetadata: {}
tracing:
zipkin:
address: zipkin.istio-system:9411
enablePrometheusMerge: true
rootNamespace: istio-system
trustDomain: cluster.local
meshNetworks: 'networks: {}'

重启下istiod 连接MCP server同步信息

1
kubectl rollout restart -n istio-system deployment istiod
Read more »

关注公众号 尹安灿

Istio EnvoyFilter+Lua 简单实现动态路由转发

因为种种原因,我们需要实现一个将服务名和subset携带在http请求的header里面,根据这个来实现将服务转发去特定的istio的服务的subset。

比如以下example:

  • 携带 service: msg-group tag: gray 的话,将其路由去msg-group 的gray subset。

    该版本返回数据: Call Read from msg-group,By New version!!!!

  • 携带 service: msg-group tag: default 的话,将其路由去msg-group 的default subset。

    改版本返回数据: Call Read from msg-group

用istio的Virtual Service来实现

大概如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
name: onroute-com
namespace: develop
spec:
gateways:
- msggroup-gateway # 这个gateway - '*'
hosts:
- onroute.com
http:
- match:
- headers:
service:
exact: msg-group
tag:
exact: gray
route:
- destination:
host: msg-group.develop.svc.cluster.local
subset: gray
headers:
response:
set:
test: This value added By static route to gray
- match:
- headers:
service:
exact: msg-group
route:
- destination:
host: msg-group.develop.svc.cluster.local
subset: default
headers:
response:
set:
test: This value added By static route default

请求构造及结果如下:

注:10.99.20.74 是istio-ingressgateway的IP

请求 msg-group 的 gray 版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
# curl -v -H "Host: onroute.com" -H "service: msg-group" -H "tag: gray" 10.99.20.74/read
* Trying 10.99.20.74:80...
* Connected to 10.99.20.74 (10.99.20.74) port 80 (#0)
> GET /read HTTP/1.1
> Host: onroute.com
> User-Agent: curl/7.77.0
> Accept: */*
> service: msg-group
> tag: gray
>
* Mark bundle as not supporting multiuse
< HTTP/1.1 200 OK
< content-type: text/plain;charset=UTF-8
< content-length: 43
< date: Fri, 16 Sep 2022 07:36:35 GMT
< x-envoy-upstream-service-time: 7
< server: istio-envoy
< test: This value added By static route to gray
<
* Connection #0 to host 10.99.20.74 left intact
Call Read from msg-group,By New version!!!!%

请求 msg-group 的 default 版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
curl -v -H "Host: onroute.com" -H "service: msg-group" -H "tag: default" 10.99.20.74/read
* Trying 10.99.20.74:80...
* Connected to 10.99.20.74 (10.99.20.74) port 80 (#0)
> GET /read HTTP/1.1
> Host: onroute.com
> User-Agent: curl/7.77.0
> Accept: */*
> service: msg-group
> tag: default
>
* Mark bundle as not supporting multiuse
< HTTP/1.1 200 OK
< content-type: text/plain;charset=UTF-8
< content-length: 24
< date: Fri, 16 Sep 2022 07:38:41 GMT
< x-envoy-upstream-service-time: 12
< server: istio-envoy
< test: This value added By static route default
<
* Connection #0 to host 10.99.20.74 left intact
Call Read from msg-group%

能实现问题,但是有几个小问题

  1. 配置不够灵活,如果面对几百个服务,配置是个巨大的工作量。
  2. 不同的namespace要配置不同的规则。

用Envoy Filter + Lua来实现

针对上面提到的问题,如果用EnvoyFiltter来实现动态的路由的话,就可以解决这个问题。

解决思路都是围绕config.route.v3.RouteAction cluster_header 这个字段来的

(string) Envoy will determine the cluster to route to by reading the value of the HTTP header named by cluster_header from the request headers. If the header is not found or the referenced cluster does not exist, Envoy will return a 404 response.

  1. 设置route的cluster_header字段为 x-service
  2. 从header读取service和tag的值组合出upstream cluster格式,并将x-service头替换为它
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
apiVersion: networking.istio.io/v1alpha3
kind: EnvoyFilter
metadata:
name: onroute-routing
namespace: istio-system
spec:
workloadSelector:
labels:
istio: ingressgateway
configPatches:
- applyTo: VIRTUAL_HOST
match:
context: GATEWAY
patch:
operation: ADD
value:
name: dynamic_routing
domains:
- 'onroute.com'
- 'onroute.com:*'
routes:
- name: "path-matching"
match:
prefix: "/"
route:
cluster_header: "x-service"
- applyTo: HTTP_FILTER
match:
context: GATEWAY
listener:
filterChain:
filter:
name: "envoy.http_connection_manager"
subFilter:
name: "envoy.router"
patch:
operation: INSERT_BEFORE
value:
name: envoy.service-helper
typed_config:
"@type": "type.googleapis.com/envoy.extensions.filters.http.lua.v3.Lua"
inlineCode: |
function envoy_on_request(request_handle)
local headers = request_handle:headers()
local mesh_service = headers:get("service")
local tag = headers:get("tag")
if mesh_service ~= nil then
if tag ~= nil then
request_handle:headers():replace("x-service", "outbound|80|" .. tag .. "|" .. mesh_service .. ".svc.cluster.local")
end
end
end

function envoy_on_response(response_handle)
response_handle:headers():add("test", "from envoy filter response")
end

下面是测试结果:

请求 msg-group的 gray 版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
curl -v -H "Host: onroute.com" -H "service: msg-group.develop" -H "tag: gray" 10.99.20.74/read
* Trying 10.99.20.74:80...
* Connected to 10.99.20.74 (10.99.20.74) port 80 (#0)
> GET /read HTTP/1.1
> Host: onroute.com
> User-Agent: curl/7.77.0
> Accept: */*
> service: msg-group.develop
> tag: gray
>
* Mark bundle as not supporting multiuse
< HTTP/1.1 200 OK
< content-type: text/plain;charset=UTF-8
< content-length: 43
< date: Fri, 16 Sep 2022 08:07:29 GMT
< x-envoy-upstream-service-time: 16
< server: istio-envoy
< test: from envoy filter response
<
* Connection #0 to host 10.99.20.74 left intact
Call Read from msg-group,By New version!!!!%

请求 msg-group的 default 版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
curl -v -H "Host: onroute.com" -H "service: msg-group.develop" -H "tag: default" 10.99.20.74/read
* Trying 10.99.20.74:80...
* Connected to 10.99.20.74 (10.99.20.74) port 80 (#0)
> GET /read HTTP/1.1
> Host: onroute.com
> User-Agent: curl/7.77.0
> Accept: */*
> service: msg-group.develop
> tag: default
>
* Mark bundle as not supporting multiuse
< HTTP/1.1 200 OK
< content-type: text/plain;charset=UTF-8
< content-length: 24
< date: Fri, 16 Sep 2022 08:12:40 GMT
< x-envoy-upstream-service-time: 14
< server: istio-envoy
< test: from envoy filter response
<
* Connection #0 to host 10.99.20.74 left intact
Call Read from msg-group%

参考资料

关注公众号 尹安灿

0%